遅延演算#
import polars as pl
import numpy as np
import threading
from helper.jupyter import row
Polars の遅延演算は、クエリをすぐには実行せず「実行計画」として蓄積し、最適化してからまとめて実行する仕組みです。主な利点は次のとおりです。
自動最適化 — 不要な計算の省略と操作順序の最適化
メモリ効率 — 必要なタイミングでのみ処理を実行
大規模データ対応 — メモリ不足のリスクを低減
基本フロー#
DataFrame.lazy()メソッドでLazyFrameに変換するか、scan_*()関数で直接ファイルからLazyFrameを取得します。フィルタや集計などの処理チェーンを構築します。
collect()で最終実行するか、explain()やshow_graph()で実行計画を確認します。
次の例では、df.lazy() で LazyFrame に変換したあと、DataFrame と同じメソッドを使って処理チェーンを組み立てます。
df = pl.DataFrame({
    "product": ["A", "B", "C", "A", "B"],
    "category": ["X", "Y", "X", "Y", "X"],
    "price": [100, 200, 150, 300, 250],
    "quantity": [5, 3, 4, 2, 6]
})

lazy_operations = (
    df.lazy()
    .filter(pl.col("price") > 150)
    .filter(pl.col("price") < 280)
    .group_by("category")
    .agg(pl.col("quantity").sum().alias("total_quantity"))
)
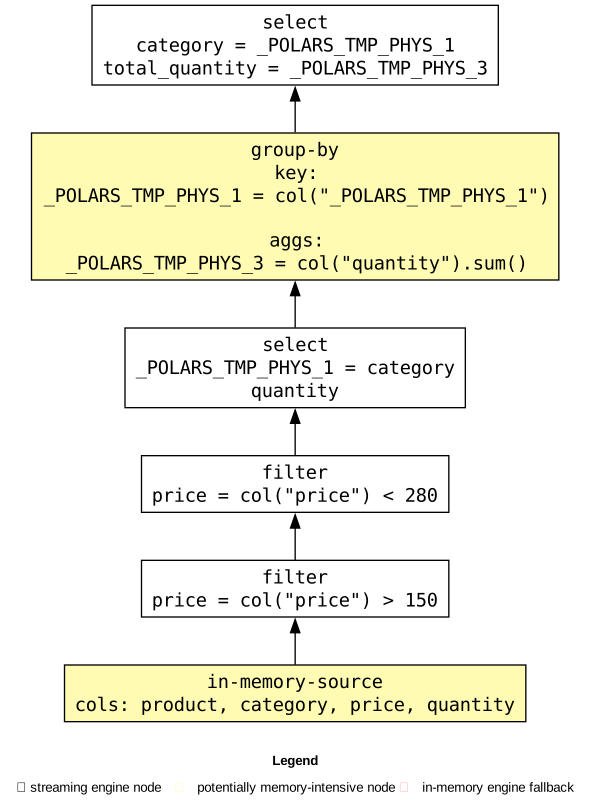
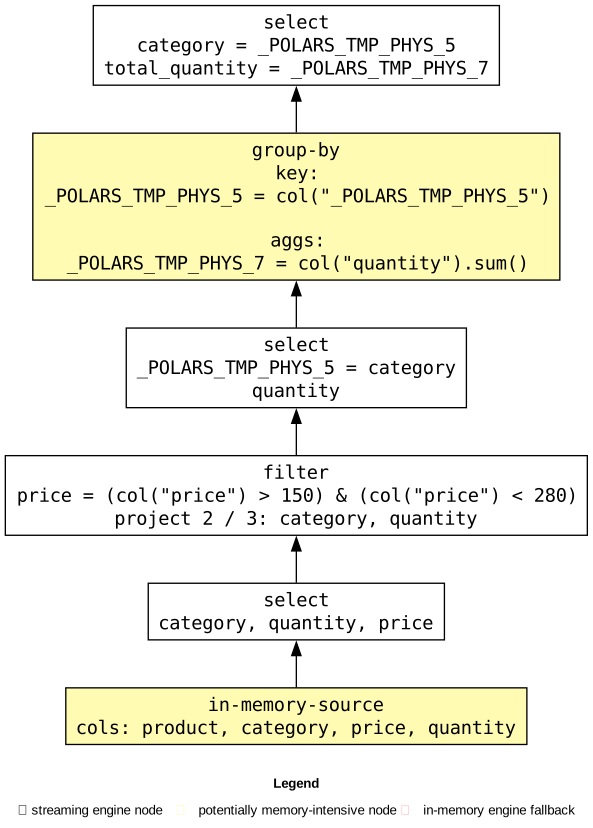
show_graph() を使うと、実行計画を確認できます。optimized 引数を True にすると、最適化後の計画が見られます。次の出力例のように、最適化後は 2つの FILTER が 1つの SELECTION に統合されます。
lazy_operations.show_graph(optimized=False)
lazy_operations.show_graph(optimized=True)
演算結果を取り出すには collect() を呼びます。
lazy_operations.collect()
| category | total_quantity |
|---|---|
| str | i64 |
| "Y" | 3 |
| "X" | 6 |
collect() を実行したあとも処理チェーンは残るので、sort() を足して再実行できます。
lazy_operations.sort("total_quantity", descending=True).collect()
| category | total_quantity |
|---|---|
| str | i64 |
| "X" | 6 |
| "Y" | 3 |
次の表に、遅延演算と即時実行の違いをまとめます。
特徴 |
遅延演算 (Lazy) |
即時実行 (Eager) |
|---|---|---|
実行タイミング |
|
各操作ごとに即時実行 |
最適化 |
自動的に実施 |
なし |
メモリ効率 |
高い |
低い(中間データ保持) |
主な用途 |
大規模データ・複雑処理 |
小規模データ・簡易処理 |
ストリーミング処理#
Polars のストリーミング処理は、大きなデータを効率よく扱う仕組みです。データを「チャンク」と呼ぶ小さな部分に分け、順に処理します。メモリ消費を抑えながら高速に処理できます。
n = 1000
df = pl.LazyFrame({
    "A": np.random.randn(n),
    "B": np.random.randn(n),
    "C": np.random.randint(0, 10, n)
})
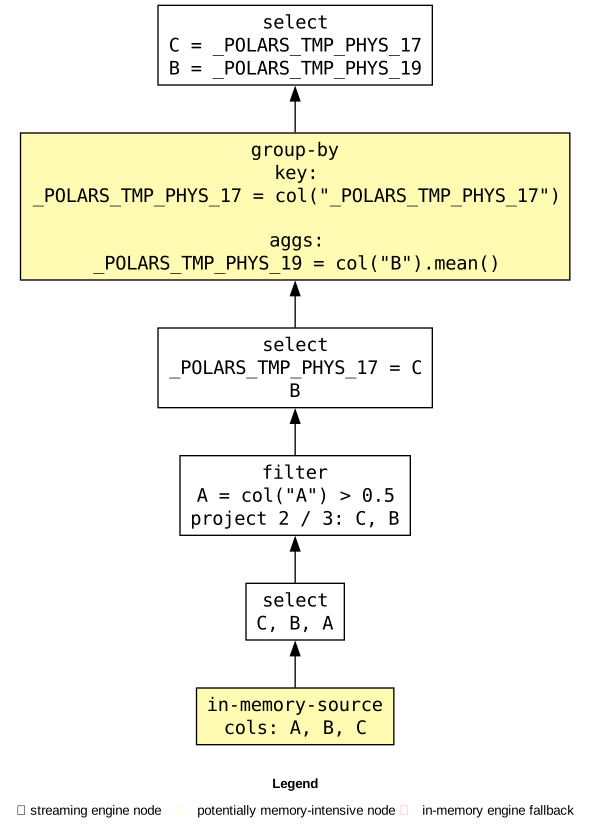
演算をストリーミングで処理できるか確認するには、.show_graph(engine="streaming", plan_stage="physical") を使います。出力されるグラフでは、白いノードはストリーミング処理できる演算、黄色のノードはストリーミング処理はできるもののメモリ使用量が増える可能性がある演算を表します。
df2 = df.filter(pl.col('A') > 0.5).group_by('C').agg(pl.col('B').mean())
df2.show_graph(engine="streaming", plan_stage="physical")
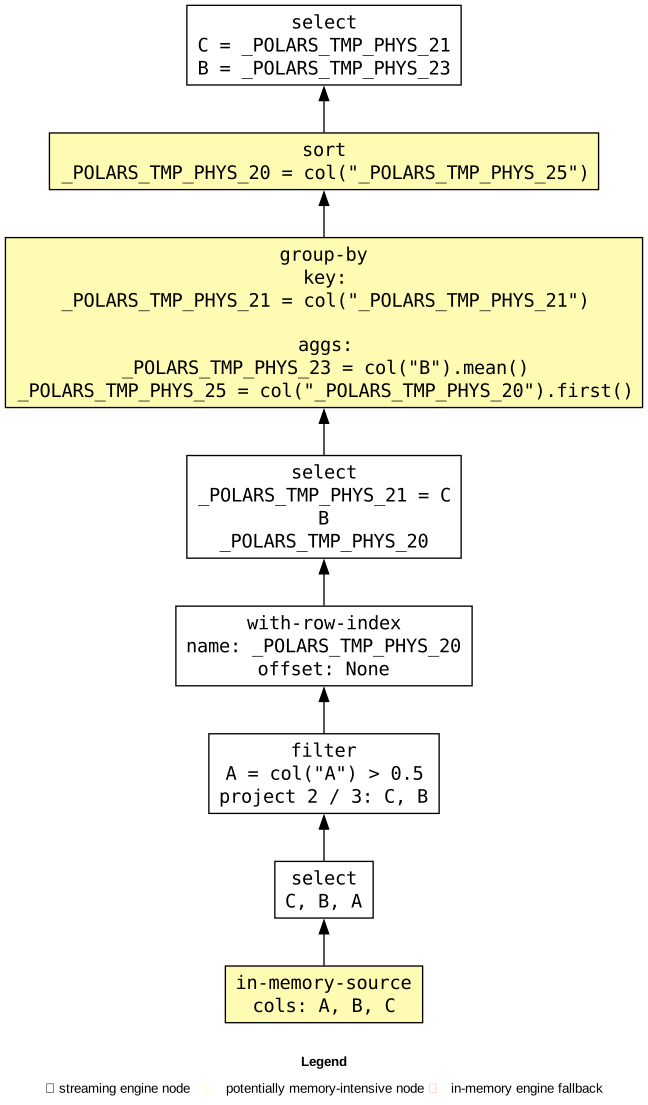
group_by() に maintain_order=True を設定すると、group_by() の演算ノードは赤く表示され、ストリーミング処理ができなくなります。この場合は "in-memory" エンジンで実行されます。
df3 = df.filter(pl.col('A') > 0.5).group_by('C', maintain_order=True).agg(pl.col('B').mean())
df3.show_graph(engine="streaming", plan_stage="physical")
ストリーミング処理で結果を計算するには、.collect(engine="streaming") を呼びます。可能であればストリーミング処理が適用され、効率よく結果を計算できます。
row(df2.collect(engine="streaming"), df3.collect(engine="streaming"))
shape: (10, 2)
|
shape: (10, 2)
|
UDF でストリーミングを観察#
ストリーミング処理のようすを観察するには、map_batches() や map_elements() などのユーザー定義関数(UDF: User-Defined Function)を使います。ユーザー関数の中でデータの長さや処理中のスレッドを出力すれば、ストリーミング処理での分割や並列処理を直接観察できます。
Expr.map_batches#
次のコードでは、2つの点に注意しています。
複数のスレッドからの出力が混在しないように、
threading.Lock()を使っています。map_batches()のis_elementwise引数をTrueにして、分割と並列処理を有効にしています。
lock = threading.Lock()
def f(s):
    with lock:
        print(s.name, s.shape, threading.current_thread())
        return s

df4 = (
    df
    .select(
        pl.col('A', 'B').map_batches(f, return_dtype=pl.self_dtype(), is_elementwise=True)
    )
    .filter(pl.col('A') > 0.5)
)
df4.show_graph(engine="streaming", plan_stage="physical")
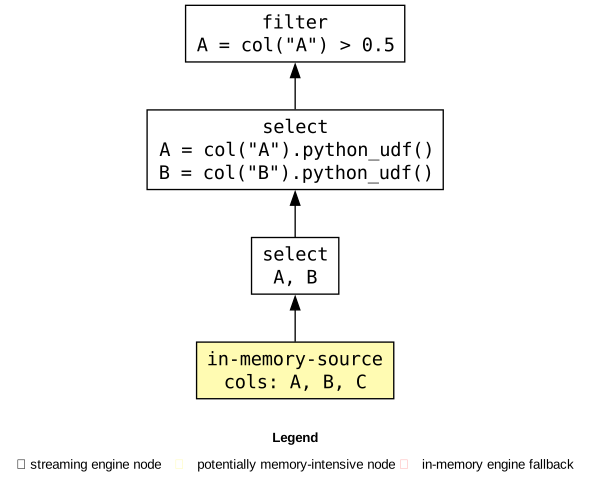
collect(engine="streaming") を実行すると、次の出力から、A 列と B 列がそれぞれ長さ 125のチャンクに分割され、別々のスレッドで並列に処理されていることが分かります。
df4.collect(engine="streaming");
A (50,) <_DummyThread(Dummy-13, started daemon 32660)>
A (50,) <_DummyThread(Dummy-14, started daemon 1272)>
A (50,) <_DummyThread(Dummy-15, started daemon 20080)>
A (50,) <_DummyThread(Dummy-16, started daemon 17200)>
A (50,) <_DummyThread(Dummy-17, started daemon 6588)>
A (50,) <_DummyThread(Dummy-18, started daemon 26764)>
B (50,) <_DummyThread(Dummy-19, started daemon 26764)>
B (50,) <_DummyThread(Dummy-20, started daemon 26764)>
B (50,) <_DummyThread(Dummy-21, started daemon 17200)>
A (50,) <_DummyThread(Dummy-22, started daemon 14532)>
A (50,) <_DummyThread(Dummy-23, started daemon 34736)>
A (50,) <_DummyThread(Dummy-24, started daemon 4748)>
A (50,) <_DummyThread(Dummy-25, started daemon 19872)>
B (50,) <_DummyThread(Dummy-26, started daemon 19872)>
B (50,) <_DummyThread(Dummy-27, started daemon 19872)>
B (50,) <_DummyThread(Dummy-28, started daemon 26764)>
A (50,) <_DummyThread(Dummy-29, started daemon 17316)>
A (50,) <_DummyThread(Dummy-30, started daemon 33440)>
A (50,) <_DummyThread(Dummy-31, started daemon 11936)>
B (50,) <_DummyThread(Dummy-32, started daemon 11936)>
B (50,) <_DummyThread(Dummy-33, started daemon 11936)>
B (50,) <_DummyThread(Dummy-34, started daemon 34736)>
A (50,) <_DummyThread(Dummy-35, started daemon 36292)>
A (50,) <_DummyThread(Dummy-36, started daemon 30328)>
B (50,) <_DummyThread(Dummy-37, started daemon 30328)>
A (50,) <_DummyThread(Dummy-38, started daemon 24512)>
B (50,) <_DummyThread(Dummy-39, started daemon 6588)>
B (50,) <_DummyThread(Dummy-40, started daemon 6588)>
B (50,) <_DummyThread(Dummy-41, started daemon 6588)>
A (50,) <_DummyThread(Dummy-42, started daemon 9540)>
A (50,) <_DummyThread(Dummy-43, started daemon 20340)>
B (50,) <_DummyThread(Dummy-44, started daemon 20340)>
B (50,) <_DummyThread(Dummy-45, started daemon 32660)>
B (50,) <_DummyThread(Dummy-46, started daemon 1272)>
A (50,) <_DummyThread(Dummy-47, started daemon 23088)>
B (50,) <_DummyThread(Dummy-48, started daemon 20080)>
A (50,) <_DummyThread(Dummy-49, started daemon 19524)>
B (50,) <_DummyThread(Dummy-50, started daemon 33440)>
B (50,) <_DummyThread(Dummy-51, started daemon 11936)>
B (50,) <_DummyThread(Dummy-52, started daemon 4748)>
また、in-memory エンジンを使う場合、A 列と B 列はチャンクに分割されず、それぞれ全体を別のスレッドで処理していることが分かります。
df4.collect(engine="in-memory");
A (1000,) <_DummyThread(Dummy-53, started daemon 34480)>
B (1000,) <_DummyThread(Dummy-54, started daemon 36828)>
scan_*() 関数でファイルから読み込んで処理する場合、データの長さが事前に分からないため、次のコードの出力からも分かるように、チャンクを均等に分割できません。
df.collect().write_csv('data/streaming_test.csv')
df5 = (
    pl
    .scan_csv('data/streaming_test.csv')
    .select(
        pl.col('A', 'B').map_batches(f, return_dtype=pl.self_dtype(), is_elementwise=True)
    )
    .filter(pl.col('A') > 0.5)
)
df5.collect(engine="streaming");
A (1000,) <_DummyThread(Dummy-55, started daemon 36292)>
B (1000,) <_DummyThread(Dummy-56, started daemon 36292)>
LazyFrame.map_batches#
LazyFrame の map_batches() もストリーミング処理に対応しています。有効にするには、streamable 引数を True にします。元のデータはチャンクに分割され、各チャンクが DataFrame オブジェクトとして UDF に渡されます。
lock = threading.Lock()
def f(df):
    with lock:
        print(type(df).__name__, df.shape, threading.current_thread())
        return df

df2 = df.map_batches(f, streamable=True)
df2.collect(engine="streaming");
DataFrame (50, 3) <_DummyThread(Dummy-57, started daemon 32904)>
DataFrame (50, 3) <_DummyThread(Dummy-58, started daemon 2864)>
DataFrame (50, 3) <_DummyThread(Dummy-59, started daemon 8124)>
DataFrame (50, 3) <_DummyThread(Dummy-60, started daemon 1892)>
DataFrame (50, 3) <_DummyThread(Dummy-61, started daemon 36372)>
DataFrame (50, 3) <_DummyThread(Dummy-62, started daemon 29704)>
DataFrame (50, 3) <_DummyThread(Dummy-63, started daemon 33524)>
DataFrame (50, 3) <_DummyThread(Dummy-64, started daemon 28168)>
DataFrame (50, 3) <_DummyThread(Dummy-65, started daemon 9324)>
DataFrame (50, 3) <_DummyThread(Dummy-66, started daemon 17712)>
DataFrame (50, 3) <_DummyThread(Dummy-67, started daemon 35788)>
DataFrame (50, 3) <_DummyThread(Dummy-68, started daemon 14000)>
DataFrame (50, 3) <_DummyThread(Dummy-69, started daemon 13500)>
DataFrame (50, 3) <_DummyThread(Dummy-70, started daemon 2832)>
DataFrame (50, 3) <_DummyThread(Dummy-71, started daemon 29312)>
DataFrame (50, 3) <_DummyThread(Dummy-72, started daemon 32008)>
DataFrame (50, 3) <_DummyThread(Dummy-73, started daemon 22504)>
DataFrame (50, 3) <_DummyThread(Dummy-74, started daemon 3584)>
DataFrame (50, 3) <_DummyThread(Dummy-75, started daemon 10956)>
DataFrame (50, 3) <_DummyThread(Dummy-76, started daemon 36568)>
Expr.map_elements#
map_elements() は各値を個別に UDF へ渡し、結果を集めます。ストリーミングエンジンでは、演算が複数のスレッドで並行して実行されます。
lock = threading.Lock()
def f(val):
    with lock:
        print(val, threading.current_thread())
        return val

n = 10

df = pl.LazyFrame({
    "A": np.random.randn(n),
    "B": np.random.randn(n),
    "C": np.random.randint(0, 10, n)
})

df2 = df.select(
    pl.col('A', 'B').map_elements(f, return_dtype=pl.self_dtype())
)
df2.collect(engine="streaming");
0.6864586138770998 <_DummyThread(Dummy-77, started daemon 14532)>
0.5077631592678977 <_DummyThread(Dummy-78, started daemon 6588)>
0.02756610580180565 <_DummyThread(Dummy-79, started daemon 26764)>
-0.4180533451119654 <_DummyThread(Dummy-80, started daemon 9540)>
1.2171679361935555 <_DummyThread(Dummy-81, started daemon 20340)>
-0.4652744303762815 <_DummyThread(Dummy-82, started daemon 32660)>
0.7662718570867431 <_DummyThread(Dummy-83, started daemon 19872)>
0.3135143169942756 <_DummyThread(Dummy-84, started daemon 17316)>
-0.8524606930616005 <_DummyThread(Dummy-85, started daemon 24512)>
-1.0869534038505064 <_DummyThread(Dummy-86, started daemon 1272)>
1.5587622285004517 <_DummyThread(Dummy-87, started daemon 23088)>
0.21642722111597726 <_DummyThread(Dummy-88, started daemon 20080)>
2.0988349731641054 <_DummyThread(Dummy-89, started daemon 19524)>
0.7017092459671415 <_DummyThread(Dummy-90, started daemon 11936)>
2.335068242511106 <_DummyThread(Dummy-91, started daemon 33440)>
-0.47712081584907146 <_DummyThread(Dummy-92, started daemon 4748)>
-0.559973307261204 <_DummyThread(Dummy-93, started daemon 17200)>
-0.18250152517864754 <_DummyThread(Dummy-94, started daemon 34736)>
0.9689142546158307 <_DummyThread(Dummy-95, started daemon 30328)>
0.2664996833913469 <_DummyThread(Dummy-96, started daemon 36292)>
df2.collect(engine="in-memory");
0.6864586138770998 <_DummyThread(Dummy-97, started daemon 34480)>
-0.8524606930616005 <_DummyThread(Dummy-97, started daemon 34480)>
0.02756610580180565 <_DummyThread(Dummy-97, started daemon 34480)>
0.3135143169942756 <_DummyThread(Dummy-97, started daemon 34480)>
0.5077631592678977 <_DummyThread(Dummy-97, started daemon 34480)>
-0.4180533451119654 <_DummyThread(Dummy-97, started daemon 34480)>
0.7662718570867431 <_DummyThread(Dummy-97, started daemon 34480)>
1.2171679361935555 <_DummyThread(Dummy-97, started daemon 34480)>
-0.4652744303762815 <_DummyThread(Dummy-97, started daemon 34480)>
-1.0869534038505064 <_DummyThread(Dummy-97, started daemon 34480)>
1.5587622285004517 <_DummyThread(Dummy-98, started daemon 36828)>
0.9689142546158307 <_DummyThread(Dummy-98, started daemon 36828)>
2.0988349731641054 <_DummyThread(Dummy-98, started daemon 36828)>
-0.18250152517864754 <_DummyThread(Dummy-98, started daemon 36828)>
0.21642722111597726 <_DummyThread(Dummy-98, started daemon 36828)>
2.335068242511106 <_DummyThread(Dummy-98, started daemon 36828)>
-0.559973307261204 <_DummyThread(Dummy-98, started daemon 36828)>
0.7017092459671415 <_DummyThread(Dummy-98, started daemon 36828)>
-0.47712081584907146 <_DummyThread(Dummy-98, started daemon 36828)>
0.2664996833913469 <_DummyThread(Dummy-98, started daemon 36828)>